目录
一、前言
Security Agent 是之前用 vibecoding 从零写的一个渗透测试 Agent,技术栈是 LangChain + LangGraph。刚开始完全没有思路。后来读了 CyberStrikeAI 的思路,借鉴一部分。
前后写了一到两周,空余时间看看。很多第一眼像「调个参数」的问题,写下去才发现是结构问题:状态放哪一层、证据谁来回收、已确认的结论怎么才不重复验证。基础部分写完,效果还算明显——Pikachu 靶场的大部分漏洞能自己找到并落地成报告。当然比不上大佬的作品,这个项目更多还是当学习作品。目前只是 v1 基础版本,Skill、MCP 都还没适配,能用的是内置工具和 YAML 声明的命令行工具。
话说:这东西能当毕业设计吗?vibecoding 也要学吗?
二、技术架构
Security Agent 是基于 LangGraph 与 LangChain 的单 Agent Web 安全测试系统。核心不是固定扫描流水线,而是由持久化 State 驱动 规划 → 执行 → 证据回收 → 状态归并 → 知识沉淀 → 再规划 的完整闭环。
这部分面向架构评审与团队协作,重点说明系统分层、核心链路、关键工程处理和当前技术边界。
架构总览
Web 安全测试的后续动作依赖实时响应、认证状态和新证据,长任务还需要恢复、停止和过程观测。系统因此将模型决策、工具执行、状态持久化与 Web 连接拆成独立层,通过 State 和统一协议协作。
| 层级 | 核心职责 |
|---|---|
| LangGraph 控制层 | 节点编排、条件路由、Action 循环、Fact Sync、恢复入口与终止判定 |
| LangChain 模型层 | Provider 适配、流式响应、原生 Tool Calling、结构化输出与 Prompt Cache |
| Tool Runtime | 工具注册、Schema 可见性、运行开关、调用复检、进程执行与结果归一化 |
| State / Storage | Agent State、Checkpoint、Project Fact、Vulnerability、Artifact 与遥测持久化 |
| Web Runtime | 后台任务、SSE 订阅、断线续接、State 查询、运行控制与前端可观测性 |

图中实线表示主控制与数据链路,虚线表示不改变主路由的旁路能力,包括节点级 Checkpoint 和运行事件流。
核心术语
| 术语 | 项目内含义 |
|---|---|
| Agent State | Conversation 级决策黑板,保存当前控制状态、Action、摘要和索引 |
| Action / Completed Action | Planner 生成的工具执行指令,以及 Executor 写回的实际执行记录 |
| Run | Conversation 内一次独立执行实例,拥有自己的状态、Checkpoint 和输出目录 |
| Checkpoint | 节点完成后保存的可恢复 State 快照 |
| Project Fact | 从真实 Action 中沉淀、可跨 Conversation 复用的项目认知 |
| Vulnerability | 满足复现条件并进入交付链路的结构化漏洞记录 |
| Artifact | 工具输出、HTTP 响应和 Transcript 等完整原始证据 |
| Resident / Dynamic Tool | 始终提供完整 Schema 的常驻工具,以及在延迟加载启用时按需解锁的动态工具 |
运行
首次部署使用 setup.ps1 创建 .venv 并安装、校验依赖:
1 | .\scripts\setup.ps1 |
启动 Web 服务:
1 | .\.venv\Scripts\python.exe web_app.py |
模型和运行参数通过 Web 设置页配置,保存于本机 memory/*.json;config_examples/ 提供手工配置模板。memory/ 已被 Git 忽略,不提交密钥和机器级运行差异。
LangGraph 控制回环
固定扫描顺序无法适应不断变化的目标状态;一次生成过长计划又容易继续执行已经失效的假设。控制层因此采用”小批次决策、逐项执行、结果回写、重新规划”的循环,并由 route_next 统一决定下一跳。
| 节点 | 输入职责 | 输出职责 |
|---|---|---|
parse |
新任务与初始上下文 | 初始化完整可执行 State |
resume |
最近 Checkpoint 与本轮新输入 | 恢复已发生事实并清理失效执行意图 |
planner |
目标、Action 历史、摘要、事实/漏洞索引与可见工具 | Tool Call 批次或结束判断 |
executor |
action_queue[0] |
Completed Action、Artifact 引用、错误与工具状态更新 |
fact_sync |
尚未沉淀的 Action 结果 | 可跨 Conversation 复用的 Project Fact |
route_next |
当前完整 State | planner、executor、fact_sync 或结束 |
Planner
Planner 使用 LangChain 原生 Tool Calling,不要求模型生成自定义计划 JSON。Tool Call 转换为 Action 前,后端执行确定性处理:
- 只接受当前可见且启用的工具;
- 过滤 Schema 未声明参数,补充默认值,检查必填项与枚举值;
- 对名为
url、base_url的参数执行基础格式处理和有效性检查; - 单轮 Action 上限由
max_actions_per_plan控制,默认值为 5。
超出上限的 Action 不进入队列,其工具名与参数作为”未执行信息”反馈给下一轮 Planner,避免模型误认为已完成。
提高 max_actions_per_plan 可以减少 Planner 往返次数,但会扩大同一批次基于旧信息连续执行的范围;降低该值会增加规划频率,但每次决策能更快吸收最新工具结果。
Executor
Planner 生成的 Action 批次进入队列后,Executor 每次只消费一个 Action。调用前再次检查工具注册和启用状态,并建立 Project、Conversation、Run、Action 的归属上下文;执行结果统一封装后写入 completed_actions。队列清空后回到 Planner,使一次模型决策的盲执行窗口限制在一个小批次内。
Fact Sync
Fact Sync 在达到 Action 间隔、上下文压缩前、任务结束前和状态恢复后触发。它只处理同步游标之后的新 Action,并将稳定认知写入 Project Fact Store。控制回环由此不仅消费工具结果,还能把已验证认知带入后续 Run 和其他 Conversation。
State 与持久化模型
控制状态、长期知识、漏洞交付、原始证据和运行遥测具有不同生命周期。如果全部进入 State,不仅会放大 Checkpoint 和模型上下文,也会使恢复语义与数据归属混乱。系统因此按职责拆分数据源:
| 数据模型 | Scope | 权威存储 | 生命周期与用途 |
|---|---|---|---|
| Agent State | Conversation | 当前内存状态 / Run Checkpoint | 当前控制流、Action、摘要、错误和工具解锁状态 |
| Run Checkpoint | Conversation / Run | Checkpoint 文件 | 节点级恢复点与最终运行状态 |
| Project Fact | Project | SQLite | 跨 Conversation 复用的目标、认证态、技术栈、入口和约束 |
| Vulnerability | Project | SQLite | 已确认漏洞、POC、复现步骤和关键证据 |
| Artifact | Project / Conversation / Run / Action | 文件系统 | 完整工具输出、HTTP 响应和 Transcript |
| Process Event | Conversation / Turn | SQLite process_events |
节点、工具、进度和执行时间线 |
| LLM Usage | Project / Conversation / Run | SQLite llm_usage |
Token、缓存命中与模型调用耗时 |
Agent State 负责控制流,Project Fact 负责长期认知,Vulnerability 负责交付,Artifact 负责原始证据,Process Event 与 LLM Usage 负责运行观测。各层只交换必要索引和引用。
Artifact Scope 与不可覆盖证据
Executor 在工具调用期间建立包含 project_id、conversation_id 和 run_id 的 Artifact Context:
1 | artifacts/projects/{project_id}/ |
project:// 与 conversation:// 分别绑定当前项目和会话。路径解析执行 canonical path 校验,拒绝越出 Scope 的相对路径;Fact 与 Vulnerability 工具的归属 ID 由 Executor 注入,不依赖模型传参维持隔离。
YAML Command Artifact 采用 Action / Attempt 两级追加式存储。不同 Action 的输出物理隔离;同一 Action 重试时分配新的 attempt_NNNN,已存在文件拒绝覆盖,从而保留每次执行的独立证据和时间顺序。该策略只约束自动产物,write_file、edit_file 仍保留显式修改语义。
SQLite 自检与迁移
数据库文件位于 artifacts/security_agent.db。启动时通过 schema_version 比较当前版本与程序支持版本,并顺序执行缺失 Migration;单个 Migration 使用 BEGIN IMMEDIATE 事务,失败整体回滚。数据库版本高于程序支持版本时拒绝写入,连接统一启用 Foreign Key、WAL 和 Busy Timeout。
该机制使 Conversation、Project Fact、Vulnerability、遥测等结构可以随程序版本原地升级,同时避免半迁移状态继续运行。
上下文工程(Context Engineering)
上下文压力主要来自 Tool Schema 数量、单次工具大结果和多轮 Action 历史。系统不使用一种摘要策略处理全部数据,而是在内容进入模型、写入 State 和保存 Checkpoint 的不同阶段分别控制规模。
Prompt 分层与缓存
Planner Prompt 按变化频率拆分为 System Prompt、Tool Catalog、Project Memory 和 Turn State。稳定前缀与高频变化状态分离:OpenAI 路径使用 Responses API Prompt Cache Key,Anthropic 路径对稳定内容块设置 cache_control,减少重复输入成本和缓存失效范围。
分阶段规模控制
| 机制 | 解决的问题 | 触发条件 | State / Prompt 保留内容 | 完整内容位置 | 是否调用 LLM |
|---|---|---|---|---|---|
| Tool Schema 延迟加载 | 工具数量扩大 Prompt | 启用业务工具达到阈值,默认 20 | Resident 完整 Schema、Dynamic 名称索引及已解锁 Schema | YAML Registry | 否 |
| Tool Result 卸载 | 单次结果过大 | 序列化结果超过字符阈值 | 元数据、头尾预览和 Artifact 引用 | outputs/{run_id}/tool_results/ |
否 |
| Action 历史摘要 | 多轮历史累计过大 | 预计上下文达到上限的 80% | 累计摘要 + 最近约 30,000 Token Action 原文 | outputs/{run_id}/context_history/ |
是 |
| Checkpoint Action 裁剪 | Checkpoint 重复保存已归档正文 | Action 已完成摘要和 Fact Sync | Action 基本字段 + 结果状态、数量和路径 | Transcript / Tool Artifact | 否 |
启用业务工具数量未达到阈值时,Planner 获得全部已启用工具 Schema;达到或超过阈值后,Dynamic Tool 先以名称索引提供给模型。阈值由 tool_search_min_tools 控制:降低该值会更早减少 Prompt 中的完整 Schema,但可能增加 Tool Search 次数;提高该值则相反。
tool_search 命中的工具写入 Conversation State 的 unlocked_tools,下一轮开始注入完整 Schema,后续 Run 也可恢复该集合。该字段减少重复检索,但长期累积会重新增加 Prompt 中的 Schema 规模。
历史摘要触发前先执行 Fact Sync,随后把将被压缩的 Action 完整写入 Transcript Artifact,再与既有摘要合并。下一轮只携带累计摘要和近期 Action 原文;需要核对细节时,模型可通过文件工具按路径和行号回读原始 Transcript。
Checkpoint Action 裁剪不重新总结内容,只从已有可靠副本且完成知识沉淀的旧 result JSON 中删除正文、重复预览等大字段。它与 Tool Result 卸载、Action 历史摘要分别处理单个结果、推理历史和持久化快照三个规模问题。
context_metrics 是唯一进入 State 的上下文指标快照,用于记录当前估算与压缩结果;该字段每轮覆盖。Token、耗时和缓存明细不随历史进入 Planner。
工具运行时(Tool Runtime)
命令行扫描器与 Python 内置工具具有不同的启动方式、参数结构和返回格式。如果每个工具都实现独立执行链,Executor 会与具体工具耦合,新增工具也会重复实现校验、超时、输出解析和 Artifact 管理。Tool Runtime 因此以统一协议隔离模型、控制层和真实执行代码。
三类协议对象
| 对象 | 生产方 → 消费方 | 内容 |
|---|---|---|
| Tool Schema | YAML Registry → LLM | 工具名称、描述和参数约束 |
| Tool Call | LLM → Planner | 工具名称、参数和 Provider Call ID |
| Tool Result | Tool Runtime → Executor | 统一的 status/data/error 执行结果 |
YAML 同时承载”给模型看的工具声明”和”给后端看的执行配方”,Tool Registry 将工具名称映射为统一 Python callable。

执行适配
生成 Tool Schema 时只提取名称、描述和参数约束;command、cwd、timeout、输出源和 Artifact 模板等后端细节不发送给模型。
| 工具类型 | 实际执行方式 | 统一处理 |
|---|---|---|
| Command Tool | 根据 YAML 渲染命令并启动子进程 | 默认值与枚举、Profile、超时/取消、流式输出、text/json/jsonl 解析 |
| Builtin Tool | 直接调用注册的 Python 函数 | Scope 注入、运行状态复检和 Tool Result 封装 |
Executor 只依赖统一 callable 和 Tool Result,不感知底层工具类型。新增 CLI 工具主要通过 YAML 声明接入,无需改动主控制回环。
工具分类与运行开关
| 类型 | Schema 可见性 | 运行开关 |
|---|---|---|
| Resident | 始终注入完整 Schema | 强制启用,不允许前端关闭 |
| Dynamic | 按 Context Engineering 的阈值与会话解锁状态注入 | 支持前端启停 |
YAML enabled 定义版本库默认状态,memory/tool_settings.json 只保存当前机器相对默认值的 override。工具关闭后会从启用列表、Planner 可见集合、Tool Schema 和 Tool Search 结果中移除;Executor 调用前仍执行最终复检,避免历史 Action 绕过当前运行策略。
证据与知识闭环
工具输出既不等于可复用知识,也不等于已确认漏洞。系统将”当前决策依据””跨会话认知””漏洞交付”和”原始证据”分开处理,并用来源 Action 建立追溯关系。
| 输入 | 处理链路 | 最终用途 |
|---|---|---|
| 普通工具结果 | Completed Action + Artifact | 当前 Planner 决策与原始证据回读 |
| 尚未沉淀的 Action | fact_sync → Project Fact Store |
跨 Conversation 复用的稳定认知 |
| 满足复现条件的发现 | record_vulnerability → Vulnerability Store |
漏洞交付、去重与复现 |
Project Fact 保存来源 Conversation 和 Action。模型提出的每条 Fact 必须引用当前同步批次中的真实 Action ID,服务端复核后才允许写入,避免无证据结论进入项目记忆。
Vulnerability 保存入口、参数、请求方法、POC、复现步骤、响应证据、严重程度和来源 Action,并使用项目、漏洞类型、方法、标准化 URL 与参数生成稳定去重键;重复发现更新原记录并累计出现次数。
完整扫描结果保存在 Artifact,State 和业务表只保存推理索引、交付字段及证据引用。最终链路为:
1 | 工具证据 → Completed Action → Planner 判断 |
Checkpoint、恢复与停止
长时间扫描可能因用户停止、进程异常或服务重启中断。系统需要保留已验证证据,但不能机械重放中断时尚未执行的队列,否则可能重复触发扫描、写文件或其他带副作用操作。
节点级 Checkpoint
Web Runtime 在每个 LangGraph 节点完成后保存 Run Checkpoint,并通过临时文件替换保证原子写入。正常完成、用户停止和异常分别写入最终 Run 状态。
Checkpoint 保存清理后的 Agent State:
- 剥离 Token、耗时等遥测字段;
- 将 Artifact 绝对路径转换为项目/会话相对引用;
- 按 Context Engineering 规则裁剪已完成知识沉淀的旧 Action。
每个 Run 复用同一 Checkpoint 文件进行节点级原子覆盖,避免重复保留整份状态历史。
State 级恢复
当前 resume 是 State 重建与重新规划,不是从中断节点机械续跑。恢复遵循”保留已经发生的事实,丢弃尚未执行的意图”:
- 保留 Completed Action、上下文摘要、Tool Search 解锁结果以及摘要和 Fact Sync 游标;
- 从 SQLite 重新加载最新 Project Fact 与 Vulnerability,避免继续使用 Checkpoint 中的过期项目索引;
- 清空未执行队列、当前 Action 和瞬时结束状态,结合本轮新输入重新规划;
- 历史 Action 尚未完成知识沉淀时,先执行 Fact Sync,再进入 Planner。
Checkpoint 不恢复外部工具进程、进行中的 HTTP/LLM 请求或 LangGraph 精确节点指针,恢复目标是重建决策依据。
取消信号与进程树停止
停止控制使用独立运行时控制面。每个活动 Run 注册内存 threading.Event,停止接口只设置 Event;取消信号不进入 Agent State、Checkpoint、SQLite 或 Planner Prompt。
Executor 只向声明支持取消的工具注入内部 _cancel_event,该参数不进入 Tool Schema。YAML Command Tool 与 search_files 已接入统一 Command Runner,执行循环通过 Event.wait(0.2) 阻塞等待,停止时立即唤醒;超时和用户取消复用同一进程树终止入口。
Windows 下优先通过 Job Object 终止父进程和全部派生进程,并以 taskkill /T /F 兜底;其他平台按进程组终止。已经产生的部分输出和 Artifact 保留,Tool Result 标记为 stopped,未执行队列被清空,最终 State 以停止状态写入 Checkpoint。
Web 运行时与可观测性
扫描任务通常长于一次浏览器连接,运行状态、控制台日志和性能数据的频率也完全不同。Web Runtime 将任务执行、SSE 订阅、高频输出和遥测持久化拆开,避免页面生命周期或日志流量影响 Agent。
| 通道 | 实现 | 职责 |
|---|---|---|
| Agent 执行 | 独立后台线程 | 任务生命周期不依赖页面连接 |
| 状态事件 | AgentEventStream + SSE |
模型增量、节点状态、工具进度和结果推送 |
| 控制台日志 | tool_console_tails 快照 |
隔离高频 stdout/stderr |
| 运行遥测 | process_events / llm_usage |
执行时间线、Token、缓存命中和耗时 |
| State 查询 | 项目黑板与 Run API | 展示持久化后的真实 State 和业务数据 |
后台执行与 SSE 续接
SSE 只是 AgentEventStream 的订阅者,不承载 Agent 任务本身。页面刷新、关闭或网络断开只移除当前订阅,后台线程和 LangGraph 链路继续运行。
事件流为每条事件分配连续序号并保留最近一段内存历史。前端重连时提交最后收到的序号,服务端先补发遗漏事件,再恢复实时推送;轮次标识用于隔离同一 Conversation 中的不同任务,避免重复展示和跨轮混合。
高频工具输出隔离
外部工具可能持续产生大量 stdout/stderr。如果逐行写入 SSE 重放历史和 process_events,长任务会放大内存、数据库与页面恢复成本。当前在线页面仍可实时接收输出,但后台按 Action、stdout/stderr 分别维护最近 120 行、单流最多 64 KB 的滚动窗口,并以快照写入 tool_console_tails。
页面刷新后恢复最近控制台记录;工具正式结果仍进入 Tool Result 与 Artifact 链路。Console Tail 只负责运行过程展示,不替代原始证据。
遥测与 State 可见性
Node、Tool、Agent 耗时和过程事件写入 process_events;模型 Token、缓存命中和调用耗时写入 llm_usage。运行中通过 SSE 推送,页面刷新后从 SQLite 重建,不进入 Agent State、Checkpoint 或 Planner Prompt。
前端项目黑板直接查询持久化数据,可查看:
- Project Fact 与 Vulnerability;
- 项目下全部 Conversation 及其最新 State;
- Conversation 历史 Run、运行状态、步骤数和 Action 数;
- 指定 Run 的原始 Checkpoint JSON。
Run 状态覆盖 running、completed、stopped、error,并对历史遗留状态派生 interrupted、superseded 和 read_error。前端按项目、Conversation、Run 分级加载,避免一次性反序列化全部 Checkpoint。
当前技术边界与演进方向
以下方向用于说明现有边界,不代表已经实现:
| 领域 | 当前边界 | 可演进方向 |
|---|---|---|
| 取消覆盖 | YAML Command Tool 与 search_files 可立即停止;等待中的 LLM 请求和未接入取消协议的 Builtin Tool 需等待返回或超时 |
Provider 请求取消、统一 Builtin 协作式取消接口 |
| 恢复粒度 | 只恢复 State,不恢复外部进程、进行中的 HTTP/LLM 请求或精确节点指针 | Action 执行日志、租约与结果对账 |
| 副作用窗口 | 工具已产生副作用但 State 尚未提交时,重新规划可能重复执行 | 幂等键、Write-Ahead Action Journal |
| 事件流 | AgentEventStream 与重放缓冲位于进程内存,服务重启后实时事件不可恢复 |
持久化事件流与分布式订阅 |
| 数据库 | SQLite 适合当前单实例部署 | 共享数据库、分布式任务队列和事件总线 |
| Dynamic Tool 解锁 | 解锁集合随 Conversation State 持久化,长期会话可能持续累积 | TTL、LRU 或阶段性回收策略 |
三、运行示例
登录与鉴权

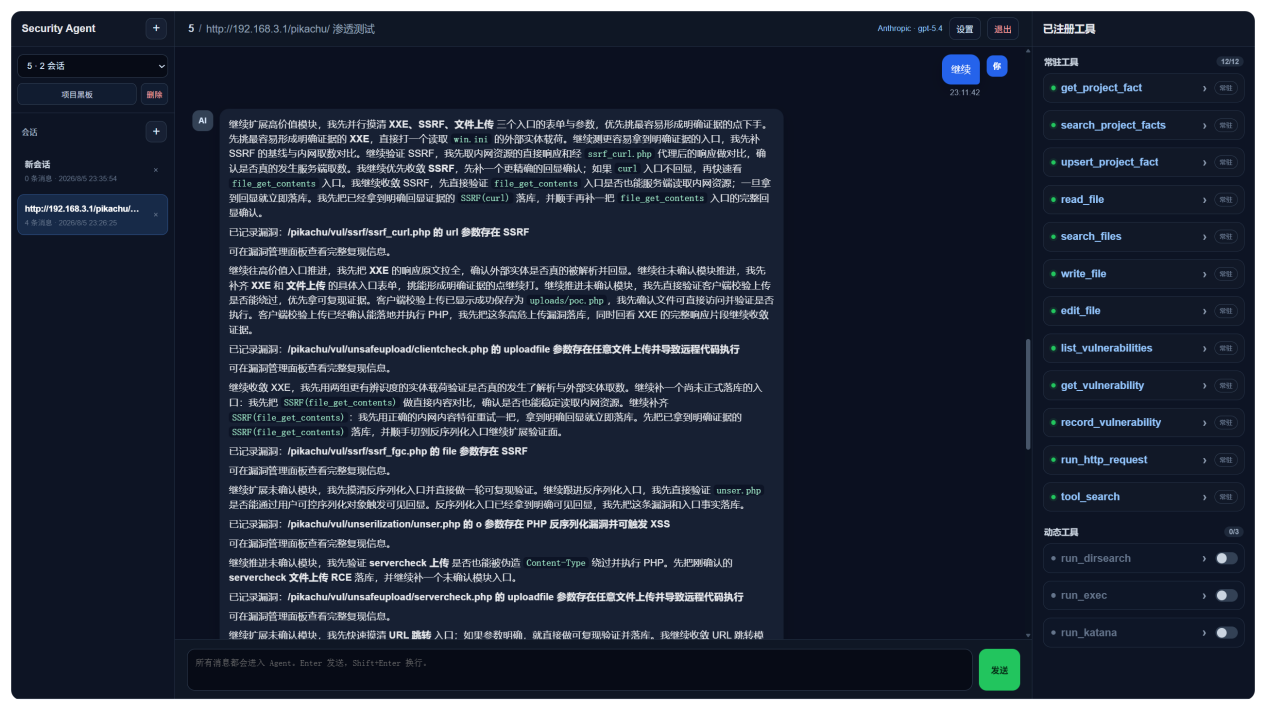
主界面
登录后进入主界面:左侧可以新建、删除项目或者会话,同一个项目下的所有会话共享项目黑板(关键信息和漏洞报告);右侧显示当前注册的工具,分为常驻工具和动态工具两类,动态工具可以自定义开关。

靶场实测
本次测试目标是 Pikachu 靶场 http://192.168.3.1/pikachu/。

简单漏洞可以被很快发现,这一阶段总共耗时 4 分 57 秒,完成了阶段性验证并确认了 4 个漏洞:除了漏洞本身,Agent 还沉淀了两条补充事实:并据此给出下一步的推进建议。

过程可观测
任务执行过程是完全可展开的。任务执行流程面板中可以看到节点流程图(planner → executor → planner → fact_sync)、LLM Token 统计(调用次数、累计 Token、缓存读取量、缓存命中率与当前上下文占用)、关键事件列表和工具执行记录。

点击任意节点可以查看更详细的信息:执行序号、状态、耗时、处理事件数,节点处理过程中的 Token 使用与 Fact Sync 结果,以及节点开始和完成时的原始数据。

中断与续跑
长任务难免会因为各种情况中断。Agent 对各类终止场景都做了适配,不会卡住进程;已经确认并落地的漏洞记录与当前执行状态都会保留下来,前端页面刷新也不会影响流式输出的显示。

中断之后再次对话,可以接着上次的信息继续推进,不需要从头再来一遍。
项目黑板
项目黑板是整个项目的共享面板,分为项目事实、漏洞管理和会话 State 三个视图。
项目事实是同一个项目下不同会话共同维护的知识信息库。每条事实都有归属模块、状态与确认来源,例如「不安全文件下载模块暴露下载端点」被标记为 surface / confirmed,而「XXE 练习入口……」因为只完成了概述层面的判断,标记为 surface / observed。

漏洞管理里是找到并落地的漏洞。下面这次测试大概总共花了 20 分钟,落地了 10 个漏洞,覆盖 CRITICAL、HIGH、MEDIUM 三个级别。
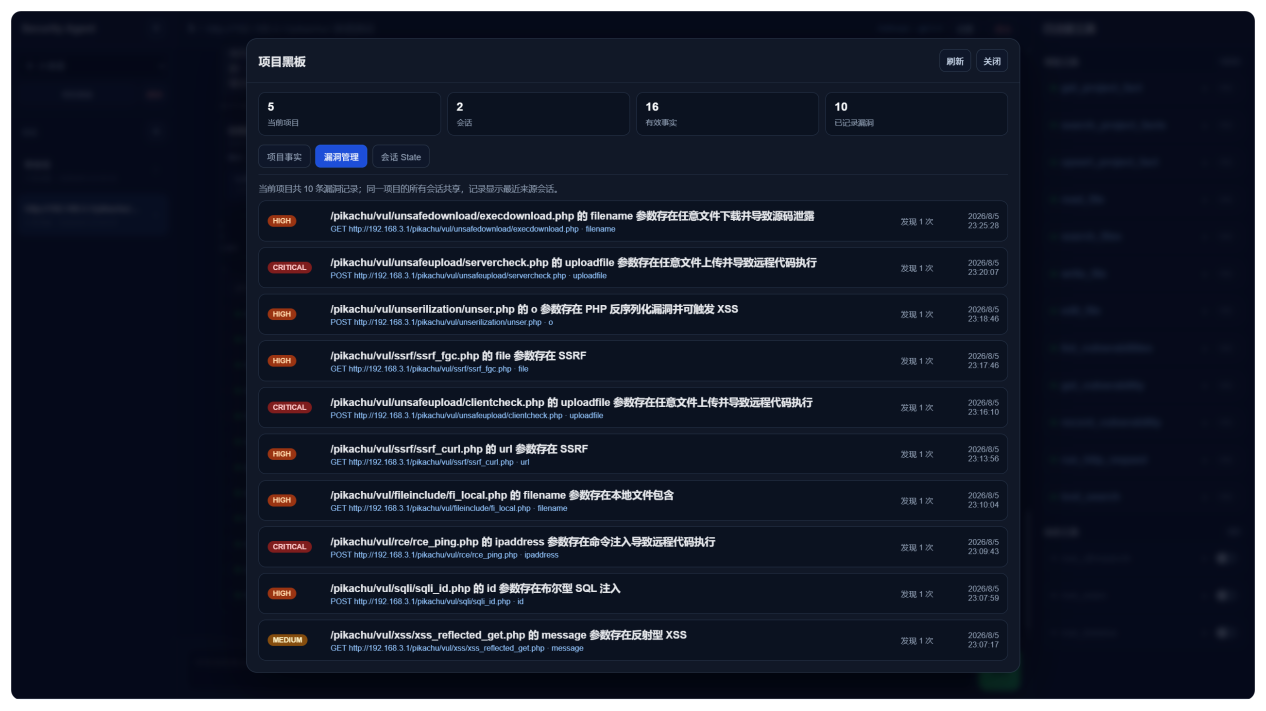
点击任意一条可以看到对应的漏洞报告,包括 POC、复现步骤、验证证据(一路记录到具体的执行产物路径)、以及漏洞 ID、严重程度、CWE 和首次/最后发现时间等记录信息。

会话 State 保存的是最原始的信息。不同会话、不同对话的 State 都有保存并且能直接查看,也能切换查看该会话的历史 Run(运行状态、Action 数量、Checkpoint 体积),排查问题时相当方便。

模型与运行设置
设置页左侧是接入的 AI 模型,适配了两种协议,可以填写模型名称、Base URL 和 API Key,并支持一键检测连接、获取模型列表;系统提示词按 Planner 和 Fact Sync 分开维护,直接以 Markdown 文件的形式查看和编辑。
右侧是运行参数,包括上下文管理(最大上下文 Token、摘要触发比例、近期动作保留 Token)和 Agent 运行限制(LangGraph 最大递归步数、单轮最大 Action 数、Tool Search 启用阈值),都可以按需自定义修改。

Token 缓存
上下文成本也做了考虑:Prompt 按变化频率分层之后,稳定前缀可以命中部分缓存。在模型的调用记录里能直接看到每一次请求的缓存命中率,命中的部分会明显降低 Token 消耗和费用。

结语
以上就是这个项目的全部内容:一个基于 LangGraph 的渗透测试 Agent,从架构到落地跑通了一遍。前面「当前技术边界」里列出的那些问题都真实存在,距离真正能用的产品还有不少距离。